


most read
Building Stories
Modo Rua: Redefiniendo el desarrollo de aplicaciones mediante iteración centrada en el usuario Ago 23
Building Stories
NuStories: Adaptación de productos para clientes fanáticos en varios países Oct 30
Culture & Values
Cómo los valores y la cultura de Nu dan forma a los productos que creamos Ago 7
Careers
We are building diverse teams with the most creative and innovative professionals for each position we open.


Escrito por: Nubank Editorial
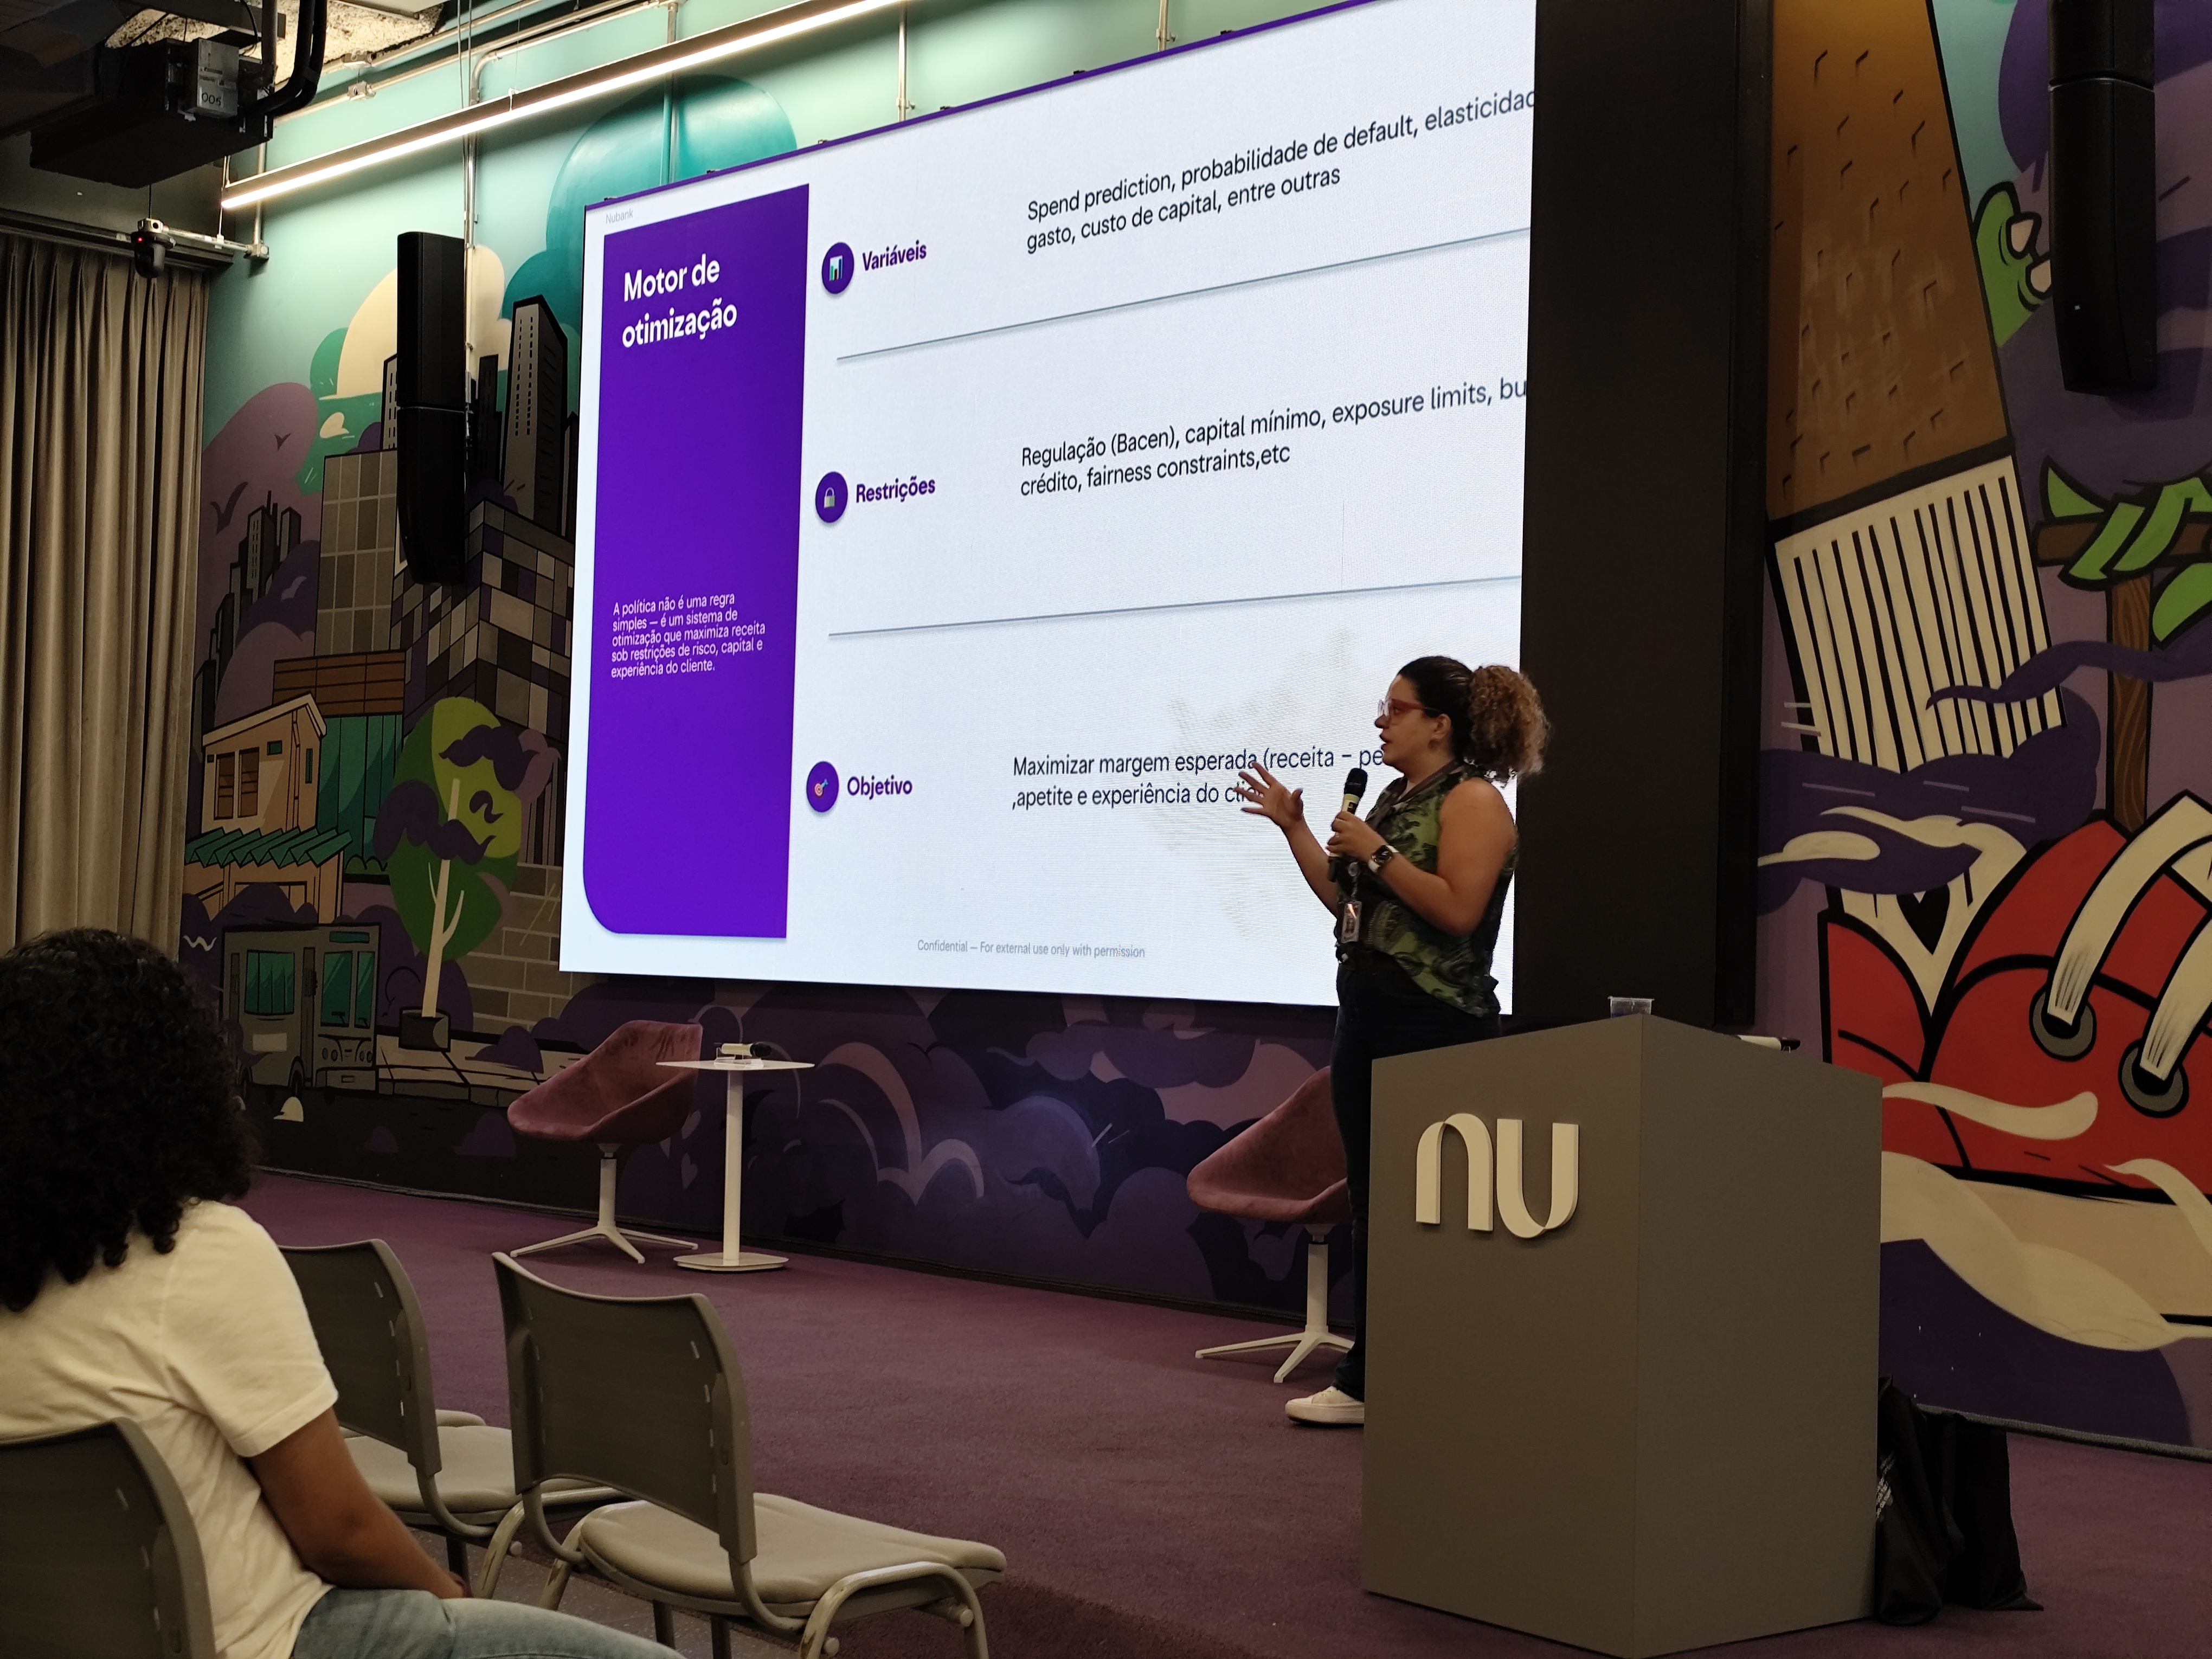
Durante el Meetup en alianza con GruPy-SP y PyLadies, realizado en la oficina de Nubank, en São Paulo, Daniela Canuta, Lead Data Scientist en Nubank, compartió una visión de alto nivel sobre cómo las técnicas de ciencia de datos pueden apoyar decisiones de aumento de límite en la tarjeta de crédito. La charla abordó temas como modelado predictivo, causalidad, optimización y monitoreo de sistemas de machine learning en producción.
En Nubank, las decisiones de crédito involucran mucho más que un análisis aislado. En líneas generales, estos procesos combinan diferentes señales, modelos y mecanismos de monitoreo para apoyar elecciones que buscan equilibrar la experiencia del cliente, la gestión de riesgo y la sostenibilidad de la operación.
Este tipo de desafío va más allá de predecir comportamiento. También exige entender qué decisiones tienden a generar valor de forma consistente para los clientes y para el negocio, siempre con responsabilidad y visión de largo plazo.
El desafío detrás de un aumento de límite
Conceder más límite es una decisión que involucra múltiples factores. De un lado, está la necesidad de ofrecer una experiencia que tenga sentido para el cliente y acompañe su recorrido financiero. Del otro, está la importancia de mantener una operación saludable, con atención al riesgo, la eficiencia y el contexto regulatorio.
En la práctica, esto significa construir sistemas capaces de analizar diferentes dimensiones de una misma decisión y apoyar elecciones más personalizadas a escala.
Check our job opportunies
El papel de los modelos predictivos
Una parte importante de este proceso está en el uso de modelos predictivos, que ayudan a estimar tendencias de comportamiento a partir de señales observadas a lo largo del tiempo. Estos modelos se alimentan de datos tratados y organizados para representar patrones relevantes, en un trabajo que combina conocimiento técnico y entendimiento de negocio.
En esta etapa, la calidad de las variables utilizadas marca una gran diferencia. Más que reunir un gran volumen de datos, el desafío es construir representaciones útiles, estables e interpretables para apoyar decisiones consistentes.
También por eso, no siempre la solución más compleja es la mejor. Dependiendo del problema, enfoques más simples pueden ofrecer un mejor equilibrio entre performance, interpretabilidad, costo computacional y escalabilidad.
Más que predecir: priorizar bien
En los sistemas de decisión, predecir es solo parte del trabajo. En muchos casos, también es importante priorizar correctamente qué situaciones merecen más atención y qué decisiones tienden a generar mejores resultados relativos.
Esto exige evaluar no solo la precisión de las predicciones, sino también la capacidad del sistema de apoyar el ordenamiento, la priorización y la consistencia entre diferentes perfiles y contextos.
Cuando la correlación no es suficiente
Otro punto central es distinguir correlación de causalidad. En problemas reales, observar un cambio de comportamiento después de una decisión no significa, por sí solo, que una cosa haya causado la otra.
Por eso, las técnicas de análisis causal ayudan a complementar el modelado predictivo. En lugar de mirar solo lo que tiende a ocurrir, ayudan a investigar en qué contextos una determinada acción realmente marca la diferencia. Este tipo de enfoque contribuye a decisiones más eficientes, más responsables y más alineadas con la experiencia del cliente.
Los modelos en producción exigen acompañamiento continuo
Poner un modelo en producción es solo el comienzo. Con el tiempo, los datos cambian, los comportamientos evolucionan y el entorno económico se transforma. Para seguir generando valor, los sistemas de machine learning necesitan ser acompañados continuamente.
Esto incluye observar indicadores de desempeño, estabilidad y calidad operativa, además de revisar los modelos periódicamente para garantizar que sigan siendo adecuados al contexto en el que operan.
Python en el centro de este ecosistema
A lo largo de todo este recorrido, Python ocupa un papel central. El lenguaje es ampliamente utilizado en flujos de análisis, experimentación, desarrollo de modelos e integración con entornos de producción, con el apoyo de herramientas ampliamente usadas por la industria, como PySpark, Scikit-learn, PyTorch, Airflow, Docker, Databricks y Grafana.
Más que una herramienta, Python se convirtió en una parte importante de la forma en que los equipos técnicos construyen, prueban y evolucionan sistemas de decisión a gran escala.
Construyendo decisiones más responsables a escala
La combinación entre machine learning, causalidad, optimización y monitoreo muestra cómo la ciencia de datos puede contribuir a sistemas de decisión más robustos y sostenibles. En un contexto de millones de clientes, el desafío no es solo escalar tecnología, sino hacerlo con responsabilidad, consistencia y foco en la experiencia de quienes usan los productos.
A medida que áreas como Data Science, Machine Learning Engineering y Data Engineering continúan evolucionando, este tipo de enfoque tiende a volverse cada vez más relevante para el futuro de los servicios financieros digitales.
Check our job opportunies