


most read
Life at Nu
Conheça a sede do Nubank em Pinheiros, São Paulo/Brasil jan 11
Design
A nova aparência do Nubank: conheça nossa nova logo maio 17
Culture & Values
Como os valores e a cultura da Nu moldam os produtos que criamos ago 7
Careers
We are building diverse teams with the most creative and innovative professionals for each position we open.


Autores: O time de Data Science da Experimentation Platform do Nubank é composto por Abel Borges, Brando Morais, Luís Assunção, Paulo Rossi e Ramon Vilarino (em ordem alfabética).
Nenhuma funcionalidade da plataforma seria possível sem o apoio de todo o squad — um agradecimento especial a Thiago Nunes (PM), Thiago Parreiras (Product Lead) e Miguel Bitarello (Engineering Lead).
Introdução
O teste A/B é um pilar do desenvolvimento de produtos no Nubank, permitindo-nos tomar decisões baseadas em dados ao comparar diferentes versões de um produto ou funcionalidade para ver qual tem um melhor desempenho. Essa abordagem rigorosa garante que cada mudança que implementamos seja apoiada por evidências empíricas, levando à melhoria contínua e a uma experiência superior para o usuário.
No entanto, um desafio persistente na experimentação é a questão da sensibilidade do experimento. Muitas vezes, os efeitos que pretendemos medir são sutis ou pequenos, tornando-os difíceis de detectar com significância estatística. Essa limitação pode atrapalhar nossa capacidade de identificar mudanças e otimizar nossos produtos de forma eficaz. Para superar isso, nossa equipe embarcou em uma jornada para explorar técnicas avançadas de redução de variância para melhorar o poder estatístico.
Melhorar o poder estatístico se traduz diretamente em um aumento da precisão para nossas estimativas, o que, por sua vez, reduz a duração dos experimentos. Isso permite uma interação mais rápida e segura.
Entre as abordagens que investigamos, o “Experimento Controlado Usando Dados Pré-Experimento” (CUPED) se destacou. O CUPED é um método estatístico que aproveita os dados anteriores ao experimento para reduzir a variabilidade das métricas-chave. Ao considerar as diferenças de baseline (linha de base) entre as unidades experimentais, o CUPED pode melhorar significativamente o poder estatístico de nossos experimentos, tornando mais fácil detectar efeitos ainda menores, mas que são significativos.
Este artigo compartilha as 3 lições principais que aprendemos com o processo desafiador, mas gratificante, de implementar o CUPED dentro da robusta plataforma de experimentação do Nubank. Esses insights (percepções/aprendizados) oferecem uma orientação valiosa para qualquer organização que deseje aumentar a precisão e a eficiência ao escalar seus esforços de teste A/B.
Check our job opportunies
Contexto
O CUPED foi introduzido, pela primeira vez, pelos pesquisadores da Microsoft Deng e outros (2013) e tem sido amplamente utilizado em empresas como Netflix, Booking, Eppo, Walmart e muitas outras. Notas de outros pesquisadores ((Lin (2013), Deng e Hu (2015), Deng e outros (2023)) destacam a relação do CUPED com a regressão linear, e como diferentes suposições no CUPED se mapeiam para diferentes especificações de regressão.
Suponha que nosso experimento tenha uma métrica-alvo Y que é calculada usando todos os eventos para um determinado cliente após ele ser exposto ao experimento. Estamos interessados em estimar o Efeito Médio do Tratamento (ATE), então calculamos a diferença nas médias entre o tratamento e o controle,
onde Δ é um estimador não tendencioso do ATE. Suponha que somos capazes de calcular uma variável X usando eventos que ocorreram antes da exposição do cliente ao experimento. Com isso, podemos escrever:
onde θ é um parâmetro escalar. Uma vez que os sujeitos foram designados aleatoriamente entre os grupos de controle e tratamento, E(Xt) -E(Xc)= 0 e, portanto, Δ adjusted também é um estimador não enviesado do ATE.
O objetivo é escolher um valor para θ que reduza a variância do resultado Δ adjustedo máximo possível. Usando a expressão para a variância da combinação linear de duas variáveis aleatórias, podemos expandir a variância para
 Δadjusted:
Ao igualar sua primeira derivada a zero, podemos determinar o valor ótimo, θ*, que minimiza essa variância:
E finalmente temos:
Uma escolha natural para X são as medições de Y antes da exposição; por exemplo, métricas transacionais chave para um banco geralmente apresentam uma forte correlação serial (ou seja, correlação da métrica com ela mesma no passado). No entanto, esta demonstração se aplica a qualquer covariável.
Note que, se escrevemos θ* em termos das covariâncias entre as observações das unidades, em vez de entre médias, então podemos escrever:
onde θc= Cov(Xc,,Yc)/Var(Xc) e

 θt =Cov(Xt,,Yt)/Var(Xt). Em outras palavras, é uma média ponderada de dois parâmetros de cada grupo em termos de suas variâncias amostrais.
Note que θ e θ são coeficientes de regressões lineares simples por grupo, e θ* é uma combinação de ambos. Mais detalhes podem ser encontrados em Lin, Seção 2 (ou 3).
Lição 1: Esteja ciente de variâncias desiguais.
Quando os grupos de controle e tratamento têm o mesmo tamanho, θ* pode ser aproximado a partir de estatísticas agrupadas (pooled statistics), conforme descrito em Deng et al. (2013):
o que resulta em um agrupamento Δpooled. No entanto, quando os grupos do experimento têm tamanhos de amostra diferentes (nc ≠ nt) e o tratamento altera a correlação serial da métrica (Cov(Xc,Yc) ≠ Cov(Xt,Yt) ), a variância do Δpooled pode ser maior do que a variância do estimador ingênuo Δ.
Ao simular cenários com grupos altamente desiguais (divisão de 90%/10%) e a covariância do grupo de tratamento três vezes maior do que a do controle, as distribuições do ATE demonstram eficiência reduzida com uma estimativa agrupada, como ilustrado no gráfico abaixo.
No Nubank, inicialmente implementamos o CUPED estimando θpooledpara cada par de variantes em todos os experimentos. No entanto, executamos múltiplos experimentos que violam as suposições desse estimador original. Lin (2013) demonstrou que Δ*adjusted é pelo menos tão eficiente quanto tanto o quanto Δpooled. Seguindo suas conclusões, avaliamos se essa mudança seria significativa para nossas métricas e decidimos alterar nossa implementação para usar θ*. Embora pareça uma mudança menor, essa alteração melhorou significativamente a robustez e a precisão de nossas análises, levando a conclusões experimentais mais confiáveis.
Lição 2: Como Definimos uma Janela de Lookback Padrão de 42 Dias
Seguindo a decomposição de * θ como uma soma ponderada de coeficientes do tipo
 θ dentro de cada grupo, a variância de *Δadjusted pode ser reformulada como uma função dos desvios padrão da métrica e das correlações seriais (pt, pc) entre suas versões pós e pré-exposição, com
 π ∈ (0,1) sendo a taxa de amostragem do grupo de tratamento:
Observe que quanto maior a correlação entre as métricas pós-exposição e pré-exposição em termos absolutos, maior será a redução de variância. Conforme observado na seção de contexto, um método direto é definir X igual a Y no passado, o que naturalmente leva ao uso da mesma variável como a variável de controle durante a janela de observação pré-experimento. No entanto, isso levanta a questão: Como podemos determinar o período ideal de agregação de métricas pré-experimento para o CUPED?
O Nubank oferece um portfólio diversificado de produtos e serviços, que variam desde suas ofertas fundamentais de cartão de crédito até seu crescente marketplace de compras. Dada essa diversidade inerente, cada produto opera em seu próprio mercado distinto e visa um segmento diferente da base de clientes. Por exemplo, a sazonalidade de um usuário que procura voos em nosso marketplace é muito diferente daquela de quem investe em ativos de criptomoeda.
Idealmente, cada métrica e experimento teriam sua própria janela pré-experimento. No entanto, esse nível de flexibilidade e overhead de implementação não é totalmente viável em nossa plataforma. Portanto, escolhemos uma janela genérica que capturasse adequadamente a maior parte do comportamento passado do usuário sem aumentar significativamente os custos de pipeline.
Para isso, realizamos diversas simulações, mostrando os sujeitos de nossos experimentos com tamanhos de amostra e durações variadas. Essa abordagem nos permitiu incorporar dados simulados com efeitos de tratamento reais para obter a janela ideal. Nossa análise se concentrou em janelas de tempo que eram múltiplos exatos de sete, capturando e abordando os padrões semanais presentes nos dados.
Os resultados médios da redução da variância, apresentados em função da janela de retrospectiva, são detalhados abaixo.
Selecionamos uma janela de lookback fixa de 42 dias para nossa análise devido ao seu desempenho equilibrado em todas as métricas e experimentos. Este período de tempo apresentou um bom trade-off (compromisso) entre a variância minimizada e o gerenciamento dos custos computacionais do nosso pipeline de métricas. Também descobrimos que uma janela de 42 dias é suficiente para capturar a dinâmica média dos negócios, em particular, englobando pelo menos um ciclo de faturamento de cartão de crédito, garantindo uma visão abrangente do comportamento e da atividade financeira do cliente.
No entanto, o impacto real do CUPED varia significativamente em nosso ecossistema diversificado. O gráfico abaixo ilustra a distribuição da redução de variância que observamos na prática em centenas de métricas em milhares de diferentes comparações de experimentos.
Essa distribuição revela algumas percepções importantes:
Em última análise, isso mostra que, embora encontrar uma janela de lookback perfeita e universal seja desafiador, nosso período padronizado de 42 dias oferece uma redução significativa na variância para a grande maioria de nossas métricas. É um desafio encontrar bons explicadores de variância genérica
Lição 3: O efeito de encolhimento.
O caminho para integrar totalmente o CUPED não foi apenas técnico. Uma das principais razões pelas quais inicialmente hesitamos em torná-lo a visualização padrão em nossa plataforma de experimentação foi a mudança na forma como o Efeito Médio do Tratamento (ATE) é interpretado. Embora o novo estimador seja mais preciso, sua estimativa pontual também muda e pode diferir significativamente do lift (ganho) bruto e não ajustado ao qual nossas equipes estavam acostumadas.
Essa discrepância é ainda mais complicada pelo nosso uso do lift relativo como resultado principal na plataforma, calculado como o ATE dividido pela média amostral do grupo de controle.
Explicar uma métrica que combina um numerador ajustado com um denominador não ajustado adiciona outra camada de complexidade. Isso exigiu um investimento significativo em treinamento e horários de atendimento (office-hours) com nossos usuários e stakeholders para garantir que eles entendessem não apenas que os resultados eram mais precisos, mas também o porquê. Este esforço foi crucial para construir confiança e evitar a má interpretação dos resultados ajustados.
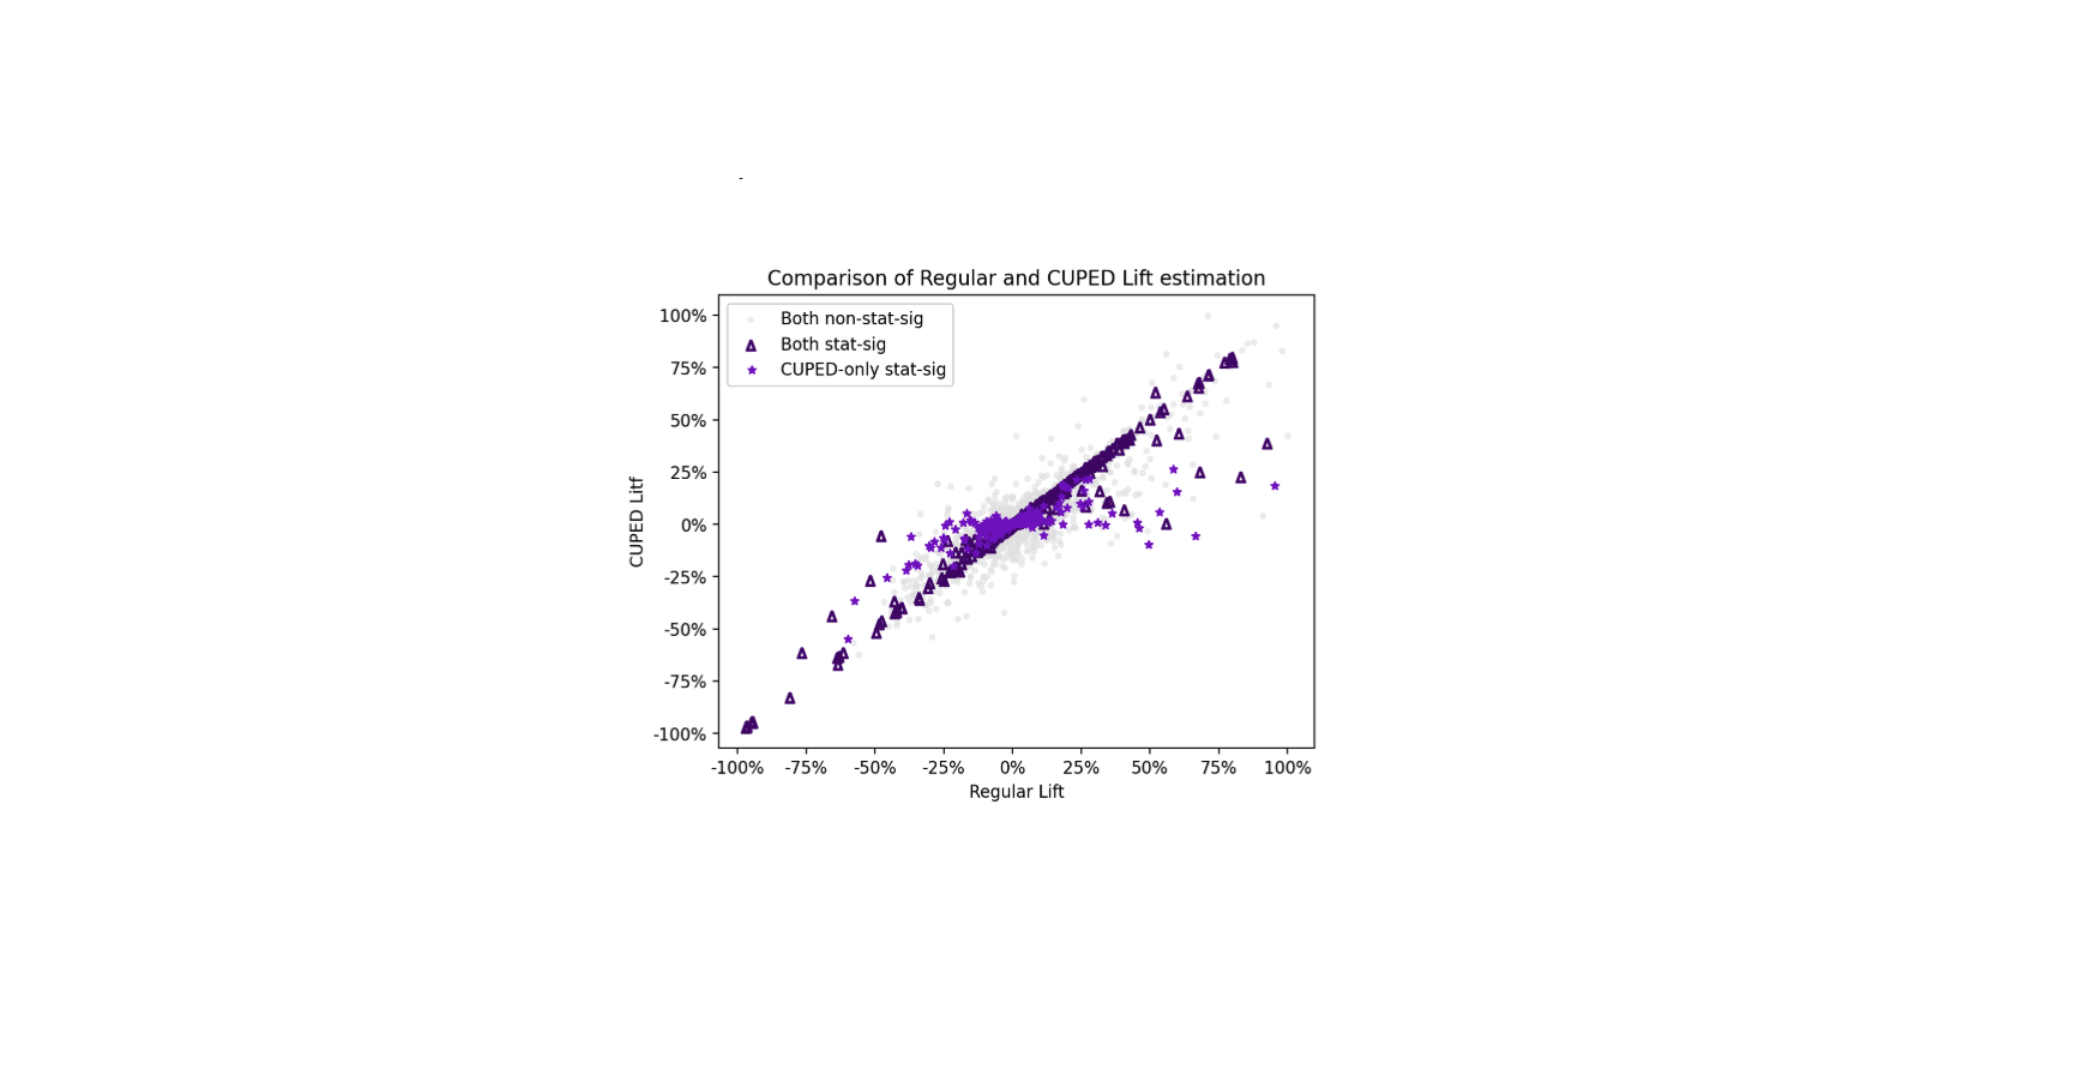
O gráfico de dispersão a seguir compara o lift relativo estimado por nossa análise padrão (“Lift Regular”) com o lift relativo estimado usando CUPED (“Lift CUPED”) em milhares de experimentos e centenas de métricas binárias e contínuas.
O gráfico revela três insights principais. Primeiro, o denso agrupamento de pontos é simétrico em torno da linha y=x. Esta observação empírica está de acordo com a teoria de que o aumento ajustado por CUPED permanece um estimador não tendencioso.
Segundo, as estrelas roxas claras representam experimentos onde a análise padrão falhou em encontrar um resultado estatisticamente significativo, mas a análise ajustada por CUPED teve sucesso. Embora a significância estatística seja uma definição arbitrária (e nós aplicamos algumas correções conservadoras, como a Bonferroni em nossos painéis de múltiplas métricas), esses pontos podem representar “vitórias ocultas” e “avisos perdidos”, descobertos devido à capacidade de CUPED de aumentar o poder estatístico.
Terceiro, um olhar mais atento a esses pontos também revela um “efeito de encolhimento” sutil, mas importante: o aumento CUPED para essas estrelas azuis é frequentemente mais próximo de zero do que a estimativa da análise regular. Este encolhimento não é uma fraqueza, mas uma característica crucial que ajuda a mitigar erros Tipo M (magnitude). Ao alcançar um maior poder para experimentos originalmente dimensionados para o estimador ingênuo, CUPED aproxima a estimativa pontual do verdadeiro efeito do tratamento em comparações estatisticamente significativas. Essas estimativas reduzidas são ilustradas como triângulos roxos escuros no gráfico.
Conclusão
A implementação do CUPED pelo Nubank em sua Plataforma de Experimentação gerou 3 insights significativos. Primeiro, é crucial estar ciente das variâncias e tamanhos de amostra desiguais entre os grupos de controle e tratamento, pois o uso de um estimador agrupado para theta (θpooled) pode diminuir a precisão, especialmente quando o tratamento altera a covariância serial da métrica. A empresa mudou para um estimador de média ponderada mais robusto (θ*) para resolver isso, o que melhorou a precisão de sua análise.
Segundo, uma janela de retrospectiva padrão de 42 dias foi escolhida como um equilíbrio prático. Embora o período ideal de dados pré-experimento varie com diferentes métricas e cenários de experimento, essa janela fixa mostrou-se eficaz na redução da variância para a maioria das métricas, sendo computacionalmente eficiente.
Por último, observamos um efeito de encolhimento onde os aumentos ajustados por CUPED para resultados estatisticamente significativos são frequentemente mais próximos de zero do que a análise regular. Esta é uma característica valiosa que ajuda a mitigar erros do Tipo M, corrigindo efeitos superestimados e fornecendo uma estimativa mais precisa e realista.
Com base no sucesso do CUPED, estamos explorando ativamente novas vias para a redução da variância. Isso inclui a investigação da incorporação de covariáveis adicionais e o desenvolvimento de metodologias robustas para padronizar técnicas avançadas de redução de variância em escala em todos os nossos esforços de experimentação. Nosso trabalho contínuo nesta área reforça o compromisso do Nubank em alavancar métodos de experimentação sofisticados, apoiando, em última análise, nossa missão de tomar continuamente melhores decisões de produto que beneficiem nossos clientes.
Check our job opportunies