


most read
Life at Nu
Conheça a sede do Nubank em Pinheiros, São Paulo/Brasil jan 11
Design
A nova aparência do Nubank: conheça nossa nova logo maio 17
Culture & Values
Como os valores e a cultura da Nu moldam os produtos que criamos ago 7
Careers
We are building diverse teams with the most creative and innovative professionals for each position we open.


Esse trabalho foi realizado colaborativamente por diversas pessoas incríveis (em ordem alfabética): Amarilis Campos, Beca Maia, Caio Sousa, Daniel Cristian, Jade Costa, Maria Duarte, Otavio Valadares, Robert Cristiam e outros times dentro do Nu.
Por que fizemos isso?
Acreditamos que, por trás de toda solução técnica, deve haver um problema de negócio claro a ser resolvido. Neste caso, estávamos enfrentando desafios relacionados à estabilidade e eficiência do nosso ecossistema de monitoramento. Com o rápido crescimento do Nubank, nossa infraestrutura de logs existente começou a mostrar sinais de pressão, especialmente em termos de previsibilidade de custo e escalabilidade.
Considerando que a plataforma de logs é fundamental para dar suporte a todas as equipes de engenharia durante a resolução de problemas e a mitigação de incidentes, não ter controle total e visibilidade sobre os seus dados de monitoramento é algo ruim. Não há nada pior do que tentar depurar um problema na produção e descobrir que você não consegue ver os logs da sua aplicação. No nosso caso, dependíamos de uma solução externa para ingestão e armazenamento dos nossos logs, e tínhamos pouca observabilidade sobre ela (irônico). Uma vez que criamos métricas para entender a situação real, nossa análise mostrou que uma parte significativa dos logs não estava sendo retida de ponta a ponta, o que limitava nossa capacidade de agir rapidamente em cenários de resposta a incidentes.
Além disso, nosso contrato estava ficando caro (muito caro). A única maneira de mitigar nossos problemas era comprando mais licenças (pagando mais), e não havia um modelo de precificação claro para planejarmos nossos gastos. Se tivéssemos problemas, teríamos que investir mais dinheiro. Nenhuma previsibilidade era possível aqui. Chegou a um ponto em que a equipe analisou que poderíamos contratar Lionel Messi como engenheiro de software, pagando o mesmo valor que estávamos pagando pela solução externa.
Com esse problema complexo e empolgante em mãos, decidimos explorar alternativas, e a mais eficiente parecia ser a criação da nossa própria plataforma. Dessa forma, teríamos controle total sobre nossos dados, pipeline de ingestão, estratégia de armazenamento e tempo de execução de consultas.
Check our job opportunies
Como era a infraestrutura de logs do Nubank?
Antes de migrar para uma solução interna, a infraestrutura de logs do Nubank era muito simples e totalmente acoplada à solução anterior.
Em resumo, cada log de aplicação era enviado diretamente para as plataformas do fornecedor pelo seu próprio forwarder. Além disso, tínhamos muitas fontes internas desconhecidas que enviavam dados diretamente para a API do fornecedor.
Essa arquitetura serviu bem ao Nubank por muitos anos, mas com nosso crescimento massivo e em hiperescala, há alguns anos, começamos a enfrentar suas limitações, e o futuro com ela passou a ser uma preocupação.
As principais preocupações e problemas identificados pela equipe com essa arquitetura e abordagem foram:
Dividir e conquistar
Construir uma plataforma de logs inteira do zero é difícil, e na época não tínhamos nada pronto!
Para resolver esse problema, dividimos todo o projeto em duas grandes etapas:
Para ambos os projetos, tínhamos um conjunto diferente de requisitos e funcionalidades a serem criados, mas havia três exigências em comum:
Com uma lista clara de requisitos e expectativas, iniciamos o projeto, primeiro focando na ingestão e no processamento, e depois na plataforma de consulta e armazenamento.
O Fluxo de Observabilidade (Observability Stream)
A decisão foi construir a plataforma de ingestão primeiro. Isso nos permitiu iniciar o processo de migração sem grandes interrupções na experiência do desenvolvedor, ao mesmo tempo que desacoplando o ambiente de transação do ambiente de observabilidade. Também nos permitiu coletar métricas sobre nossos dados para embasar melhores decisões, especialmente durante o desenvolvimento da plataforma de armazenamento.
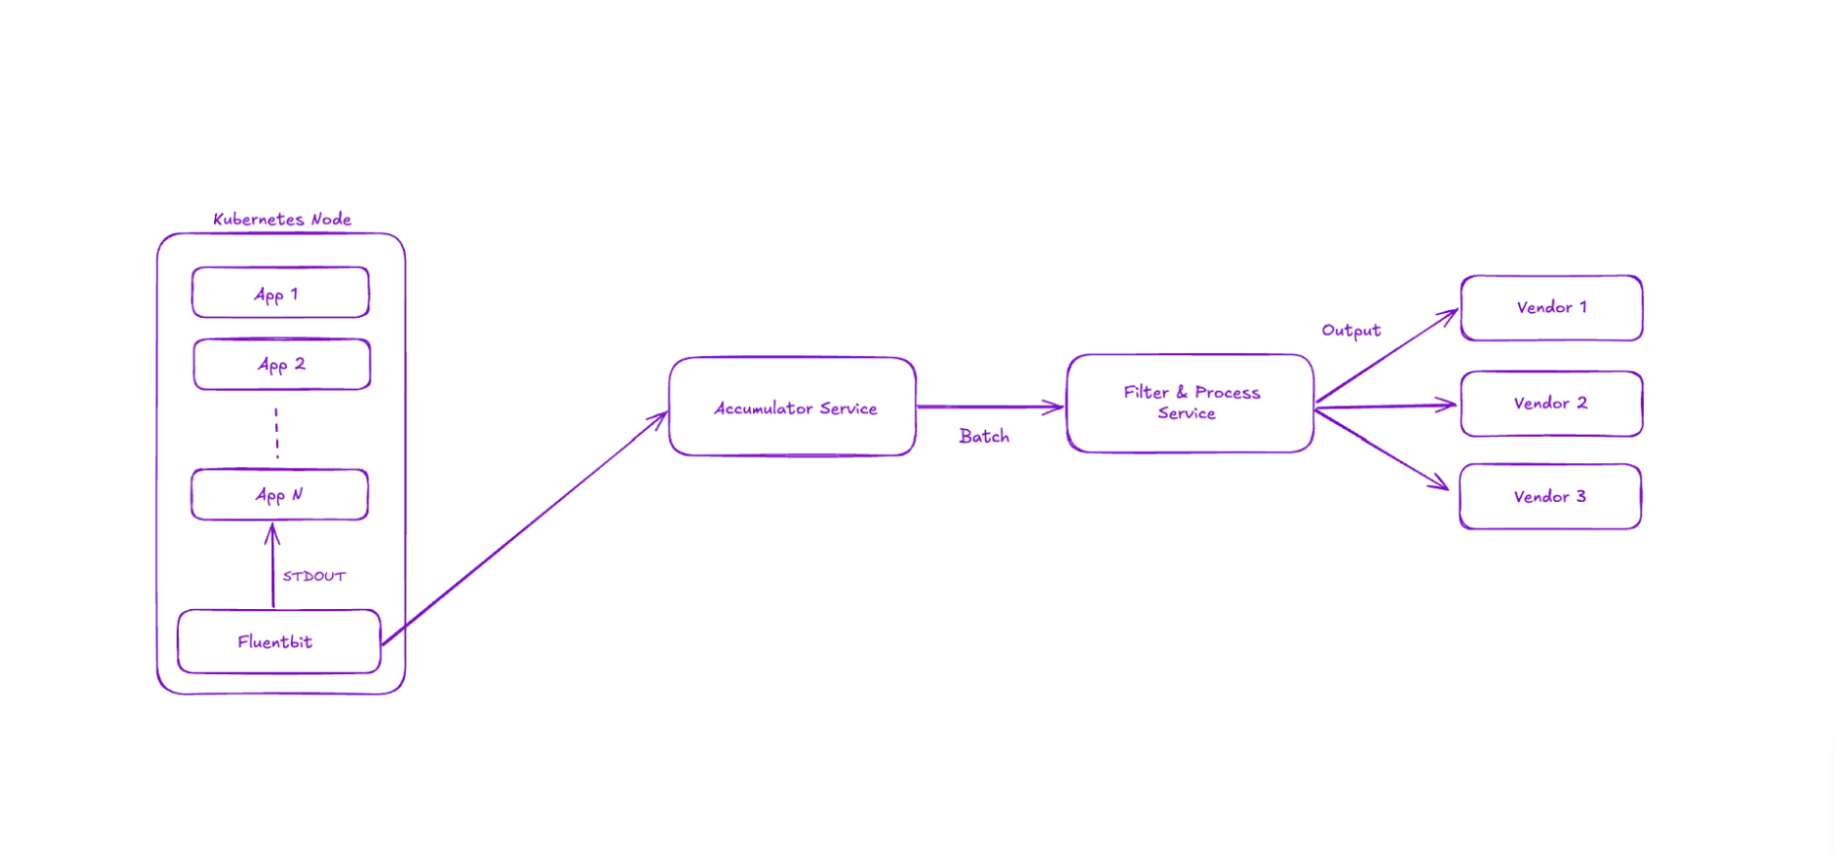
O Observability Stream foi construído com a simplicidade em mente, usando uma combinação de projetos de código aberto e sistemas desenvolvidos internamente.
Em resumo, a arquitetura de ingestão é composta por três sistemas distintos:
Com o Observability Stream totalmente operacional, estabelecemos uma base de confiabilidade e escalabilidade para nossos processos de ingestão de logs. Este sistema abrangente não apenas resolveu nossas necessidades imediatas de entrada de dados de qualidade, mas também nos forneceu informações valiosas sobre nossas atividades de registro. Além disso, ele desacoplou nossos processos de ingestão do processo de consulta, permitindo maior flexibilidade e a capacidade de trocar componentes facilmente quando necessário, uma capacidade que nos faltava anteriormente devido ao alto acoplamento.
Plataforma de Consulta e Log
Com uma plataforma de ingestão robusta que garante confiabilidade e escalabilidade, nosso próximo desafio foi desenvolver uma solução de consulta e armazenamento capaz de lidar e recuperar efetivamente esse enorme volume de dados de logs.
Com tudo isso, precisávamos escolher um motor de consulta para pesquisar todos esses dados, e o Trino foi a escolha por várias razões:
Para armazenar os logs, o formato escolhido foi o Parquet. Ao utilizá-lo, conseguimos o melhor desempenho de busca devido ao seu armazenamento colunar, além de uma taxa média de compactação de 95%. Isso nos ajuda a atingir o objetivo de ter todos os nossos dados armazenados da forma mais eficiente possível.
Para gerar todos esses arquivos Parquet, construímos uma aplicação geradora de Parquet altamente escalável e extensível, capaz de transformar todos os dados massivos vindos da plataforma de ingestão. A decisão de construir nossa própria infraestrutura interna para isso também reforça nosso objetivo de ter uma alternativa econômica, ao mesmo tempo em que podemos estender e adaptar conforme as necessidades do Nubank.
Com a nossa plataforma de consulta e logs totalmente integrada e operacional, conseguimos redefinir como o Nubank gerencia seus dados de log. A escolha estratégica do Trino para consultas, S3 para armazenamento e Parquet para o formato dos dados garante que nossos logs não apenas sejam armazenados de forma eficiente, mas também estejam prontamente acessíveis para análise e resolução de problemas. Essas inovações não só resolveram os desafios iniciais, mas também equiparam o Nubank com uma ferramenta poderosa para o crescimento futuro.
Considerações Finais
Desde meados de 2024, a plataforma de logs interna do Nubank se tornou o padrão para armazenamento e consulta de logs. Atualmente, ela ingere 1 trilhão de logs diariamente, totalizando 1 PB de dados. Com um período de retenção de 45 dias, armazena 45 PB de dados pesquisáveis. A plataforma lida com quase 15 mil consultas diárias, escaneando 150 PB de dados a cada dia.
O Nubank desenvolveu essa plataforma interna para alcançar economias de custo significativas e maior eficiência operacional, afastando-se da dependência de fornecedores externos. A plataforma é projetada para suportar todas as operações atuais e futuras, escalando de forma eficiente e custando 50% menos que as soluções de mercado, de acordo com nossos benchmarks.
Essa abordagem também proporciona ao Nubank um controle e flexibilidade incomparáveis. Ela permite a iteração rápida, o desenvolvimento de funcionalidades personalizadas e um entendimento mais profundo dos fluxos de dados, resultando em melhorias na análise, na solução de problemas e na segurança.
Desafiar o status quo é um valor central do Nubank, e essa ambição impulsionou a criação de uma plataforma de logs inteira do zero, utilizando uma combinação de projetos de código aberto e desenvolvimento de software interno.
Check our job opportunies